第 7 章 模仿学习与数据生成
不是所有任务都好写奖励。操作类任务(叠方块、装配、插拔)的"做对了"很难写成解析函数,这时改用从示范里学:人遥操作录一批示教,脚本把它们扩成上千条,再行为克隆或蒸馏出策略。本章讲这条数据管线的三段——示教采集、脚本化生成(Isaac Lab Mimic)、模仿学习落地(蒸馏/BC),并给 Isaac Replicator 合成数据划一句分界。示教采集依赖遥操作硬件,脚本化生成依赖完整 Isaac Sim;包结构与类名以仓库为准。
1. 示教从哪来:遥操作与录制
数据采集的一端是遥操作(teleoperation)。Isaac Lab 的 isaaclab_teleop 包提供设备接入与流式管线,形态包括 Apple Vision Pro(AVP)经 CloudXR 串流的手部/手部+控制器示教(仓库内含 avp-cloudxr.env 等运行配置),配套 camera_feed(第一人称观测回传)、command_handler(把设备指令转成动作)。设备接入形态与可用性随 Isaac Sim 版本与设备 SDK 变化,当前支持列表查 isaaclab_teleop 的 README 与 Isaac Sim 的 CloudXR 文档。
录下来的示教落成 HDF5 数据集——isaaclab.utils.datasets 里的 EpisodeData 与 HDF5DatasetFileHandler 定义了一集一条的存储格式(观测、动作、状态按步存)。这既是 BC 的输入,也是下一节脚本化生成的"种子示教"。
2. 脚本化数据生成:Isaac Lab Mimic
从几条人类示教批量扩出大量成功轨迹,是 isaaclab_mimic(Isaac Lab Mimic)做的事,思路源自 RoboMimic 的 MimicGen:把示教切成子任务片段,用运动规划与对象位姿对齐,把它们重组、适配到新初始条件上,生成大量几何等价的成功轨迹。管线的核心件在 isaaclab_mimic.datagen:
data_generator:把种子示教套到新场景初始状态、产出新轨迹的主循环。datagen_info_pool:从环境按任务约定抓取"生成期信息"(关键物体位姿、末端位姿、夹爪状态等),供片段对齐。selection_strategy:在源数据池里挑选可拼接的源片段。motion_planners:为不可直接套用的片段补一段规划轨迹。
任务侧以 ..._mimic_env_cfg 成对存在,例如 franka_stack_ik_rel_mimic(Franka 叠方块)——它就是"少量示教 → Mimic 扩样 → 再训练"这条线的样板。生成产物同样落 HDF5,喂给下游 BC。Mimic 需完整 Isaac Sim 环境运行;包结构与类名是源码可查的,其运行时行为以官方示例为准。
生成不是越多越好,产出仍要过三道筛:物理可行性——接触穿插、关节超限、末端加速度超阈值的轨迹一律丢;成功判据——按任务后置条件(物体最终位姿是否落在目标区)自动判定,而不是默认生成即成功;多样性——初始位姿、物体尺寸、桌面高度按任务实际分布采样,只用单一初始条件扩出的万条轨迹,学生学到的仍是那一个点位。成功率与多样性要一起报:成功率 95% 但全部挤在同一初始位姿,比成功率 60%、覆盖整个工作空间的数据集更没用。
Mimic 的一条扩样管线:
flowchart LR
    demo["种子示教<br/>少量成功轨迹"] --> pool["datagen_info_pool<br/>物体/末端位姿、夹爪状态"]
    pool --> sel["selection_strategy<br/>挑选可拼接片段"]
    sel --> plan["motion_planners<br/>补规划轨迹"]
    plan --> gen["data_generator<br/>套到新初始状态"]
    gen --> filt["三道筛:物理可行 / 成功判据 / 多样性"]
    filt --> hdf["HDF5 数据集"]
    hdf --> bc["行为克隆 / 蒸馏"]
坑:Mimic 扩样要过三道筛
物理可行(无穿插、不超限)、成功判据(后置条件达成)、多样性(初始位姿与物体尺寸按分布采样)——少一道,生成量越大错误越被放大。
3. 行为克隆与蒸馏
有了示范数据,落地有两条常见路:
蒸馏式 BC(rsl_rl 内置)。isaaclab_rl.rsl_rl 提供学生-老师(Student-Teacher)蒸馏配置:先有一个用特权观测(真值状态)训好的老师策略,再用蒸馏把它的行为克隆进一个只用部署可得观测的学生策略。相关配置类成对:
| 配置类 | 作用 |
|---|---|
RslRlDistillationRunnerCfg |
蒸馏运行器(class_name="DistillationRunner") |
RslRlDistillationStudentTeacherCfg |
学生-老师网络(class_name="StudentTeacher") |
RslRlDistillationAlgorithmCfg |
BC 损失与优化超参(class_name="Distillation") |
这条路径与第 5 章的 PPO 共用注册与 CLI:换一个 --rl_library rsl_rl 下的蒸馏 agent 配置即可,训练链不变。它的典型用法是"特权 RL 老师 → 视觉/本体可得观测的学生",把 sim-to-real 时拿不到的特权信息蒸掉。
直接 BC。对 Mimic/遥操作录的示范做监督回归(观测→动作),走 skrl/自定义 BC 或外部库;Isaac Lab 侧不把它做成像 PPO 那样的一等主线,故实操以蒸馏式为主示范。
行为克隆的短板是协变量偏移:训练分布里学生每一步都处在专家轨迹上,部署时一步偏差就把它带到训练没见过的状态,误差随之复利。补偿手段有两类——在示范上叠加扰动并记录专家的纠正动作(DAgger 式),或把学生自己跑出的失败轨迹回灌到训练集。前者需要能重跑专家的在线环境,后者只需重放与重标,工程上更常见。
3.1 示范动作的归一化契约
示范动作往往是跨量纲的:关节角(rad)、夹爪开度(m)、底盘速度(m/s)、腕部力矩(N·m)的幅值相差两个数量级。直接回归时 MSE 对各维输出的梯度幅度正比于该维标准差,量纲大的维度独占梯度:
| 维度 | 示范集标准差 | 未归一化梯度份额 | 按维归一化后 |
|---|---|---|---|
| 关节角 | 0.2995 | 21.5% | 25.0% |
| 夹爪开度 | 0.0050 | 0.36% | 25.0% |
| 底盘速度 | 0.0992 | 7.1% | 25.0% |
| 腕部力矩 | 0.9917 | 71.1% | 25.0% |
mean, std = demo.mean(axis=0), demo.std(axis=0)
z = (demo - mean) / std             # 训练输入与回归目标都落在归一化空间
grad_share = std / std.sum()        # 未归一化时各维梯度份额 ∝ std
判据:归一化统计量随示范集重算,并与权重一起落盘作为导出契约;夹爪这类小量纲维度在未归一化时只占 0.36% 的梯度,而抓取任务的成败恰恰由它决定。
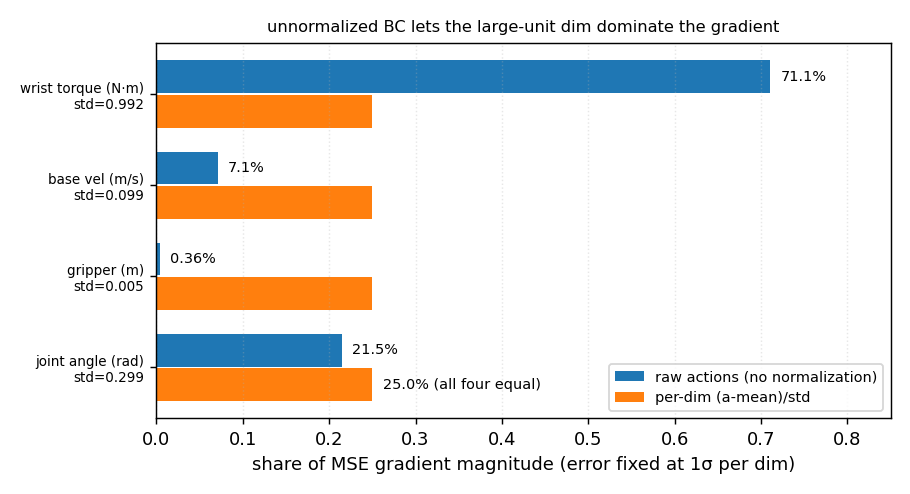
同一条误差(每维各 1σ)下两种归一化方式的梯度份额:蓝条是直接回归,份额按标准差重排,腕部力矩独占 71.1%;橙条是 (a-mean)/std 后回归,四维各 25%;横轴为份额而非绝对值。
3.2 另一条生态:LeRobot 的数据集与策略
Isaac Lab 的示范链是“仿真内生成 → rsl_rl 蒸馏/BC”,封闭但可控;需要跨平台的数据托管与真机部署时,常用 Hugging Face 的 LeRobot。它把三件事打包:统一数据集格式(LeRobotDataset:视频流 + 各模态字段 + 元数据,存 Hub)、一组参考策略(ACT、Diffusion Policy 等)、以及采集/训练/推理的命令行与 Python 接口。最小用法:
pip install lerobot
lerobot-train --policy.type=act \
  --dataset.repo_id=<user>/<dataset> \
  --output_dir=outputs/train/act_demo        # 策略与超参名随版本演进,以仓库 README 为准
from lerobot.datasets.lerobot_dataset import LeRobotDataset

ds = LeRobotDataset("lerobot/aloha_sim_insertion_human")   # 从 Hub 拉数据
sample = ds[0]                              # 含图像/状态/动作字段与 episode 索引
print(sample.keys())
与 Isaac 侧的分工:合成数据与大规模并行训练在 Isaac(本章与第 5 章),真实采集数据、跨机器人共享与轻量部署走 LeRobot;两边可经 HDF5 一类中间格式互导——本章的 Mimic 产物就是 HDF5,下游 BC 恰好能接上。判据:只在本地仿真环境里迭代就留在 Isaac 链;要在社区共享数据、或直接用别人的预训策略上真机,再引入 LeRobot。
判据:归一化契约必须与部署一致
示范动作的归一化参数(mean/std)要随 checkpoint 一起登记;换一套归一化等于换了一个策略,回滚时只认权重文件名会找不到现场那一版。
4. 合成数据的分界
再往上是大规模场景合成——Isaac Replicator。它属于 Isaac Sim 侧的批量场景/域随机化与合成数据生成工具链(程序化摆放物体、随机化材质光照、批量出带标注图像),服务感知训练而非控制示教。它未在本板块展开成专章;一句话分界:第 6 章的域随机化改的是物理与观测参数、服务于控制策略的鲁棒性,Replicator 改的是场景内容与标注、服务于感知数据集的规模与多样性。二者动机与产出物不同,勿混用。标注自动生成也不等于标注正确:标签质量取决于场景与相机模型的保真度,传感器模型理想化时,标注与真机图像的对应关系会系统性偏移。
5. 要点
- 难写奖励的操作任务转"从示范学":数据源是遥操作(
isaaclab_teleop,AVP/CloudXR 等)录成的 HDF5 示教(EpisodeData/HDF5DatasetFileHandler),设备接入形态随 Isaac Sim 版本与设备 SDK 变化。 - Isaac Lab Mimic(
isaaclab_mimic.datagen:data_generator/datagen_info_pool/selection_strategy/motion_planners)把少量示教脚本化扩成大量轨迹,样板任务如franka_stack_ik_rel_mimic;其运行时需完整 Isaac Sim 环境。 - 模仿学习落地以 rsl_rl 的学生-老师蒸馏为内置主线(
RslRlDistillation*三件套),与 PPO 共用注册与 CLI;把特权老师的行为蒸进部署可观测的学生。 - Isaac Replicator 属 Isaac Sim 侧的场景合成/标注工具链,服务感知数据,与第 6 章服务控制的域随机化是两回事,不展开成专章。