第 7 章 图像深度学习感知
前六章的几何管线给出坐标与位姿,但机器人最终要的是"这是杯子、那有空位"。图像上的学习式感知任务族——分类、检测、分割、视觉标志——以及选型判据:什么时候该用几何方法、什么时候该上深度学习、什么时候直接调基础模型。不训练基础模型,只讲结构原理与用现成权重的方式;具体包与权重的可用性标「待核实」。
任务族与输出粒度决定下游怎么接:
flowchart LR
    task["任务族:分类 / 检测 / 分割 / 标志"] --> backbone["骨干网络谱系"]
    backbone --> head["输出粒度:框 / 掩膜 / 关键点 / 位姿"]
    head --> use["下游:几何管线或直接控制"]
1. 选型判据
摆在面前的是三条路,判据落在"要不要语义、要不要可解释、有没有算力":
| 层 | 手段 | 适合 | 不适合 |
|---|---|---|---|
| 传统几何 | 阈值 / 边缘 / 模板 / 标定 PnP | 尺寸已知、光照可控、要绝对精度 | 类内差异大、需要语义 |
| 判别式深度学习 | 检测 / 分割网络 | 有限类别、有标注、要实时 | 开放词汇、零样本 |
| 基础模型 | SAM / CLIP 类 | 少样本 / 零样本、开放词汇 | 严格实时、绝对定位精度 |
一个反复出现的误区是把"能调用一个 YOLO 检测器"当成"会用视觉"——训练/推理只是起点,选型判据、后处理(NMS 阈值、置信度标定、类别不平衡)与失效评估才是主要工作量(这条在第 10 章退化场景里正面澄清)。
2. 骨干网络的谱系
所有 2D 感知任务共享一个视觉骨干(backbone)提特征,一句谱系:
- ResNet:残差连接解决深网退化,是检测/分割的经典骨干。
- ViT(Vision Transformer):把图像切 patch 当 token 做自注意力,需大数据/强增广才发挥。
- ConvNeXt:用纯卷积逼近 ViT 的设计选择,工程上更易部署。
本章不展开注意力、残差等训练侧数学(深度学习基础理论不在覆盖范围);引用骨干只为说明检测/分割头的特征来源。
骨干的实际差别常在输入分辨率与感受野:小物体检测需要高分辨率输入,算力却按像素数平方增长;ViT 类感受野更全局,小目标反而要靠特征金字塔(FPN 类 neck)把浅层细节接回来。预训练数据的域也影响迁移——在自然图像上训的骨干拿到工业灰度图上,浅层特征仍可用,深层语义要重训。
3. 任务族与输出粒度
同一骨干之上接不同头,按输出粒度分三档:
- 分类(classification):整图一个标签。
- 检测(detection):一组轴对齐框 + 类别,定位到物体级。范式分两代——锚框 + 非极大值抑制的两阶段(Faster R-CNN 类)与端到端去 NMS 的一阶段(YOLO 谱系、DETR 类,用集合预测匹配)。DETR 类把检测当集合预测、用匈牙利匹配去锚框,一句名目。
- 分割(segmentation):逐像素分类,再分三档分辨率——语义分割(每像素一个类,无实例区分)、实例分割(区分同类的不同个体)、全景分割(两者合一)。
选型:要"有几个、各在哪"用检测;要精确轮廓/掩膜(抓取点、可通行区)用分割;只问"有没有 X"用分类或开放词汇检测。
检测分数不是概率:同一个 0.6 在不同数据集上的含义不同,拿它做阈值决策前要先标定(温度缩放、分箱直方图),否则"高于某值就执行"这条规则换个场景就失效。类别不平衡时还要按类设阈,而不是全局一个值——小类分数普遍偏低,全局阈值会把它整体滤掉。
3.1 后处理:IoU 与 NMS
检测头输出的是一堆重叠候选,进下游前要合并。两个原语概括了全部后处理:交并比(intersection over union,IoU)量重叠,非极大值抑制(non-maximum suppression,NMS)按分数贪心保留。
def iou(a, b):                                 # 轴对齐框 (x1, y1, x2, y2)
    x1, y1 = max(a[0], b[0]), max(a[1], b[1])
    x2, y2 = min(a[2], b[2]), min(a[3], b[3])
    inter = max(0.0, x2 - x1) * max(0.0, y2 - y1)
    union = (a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter
    return inter / union

def nms(boxes, scores, thr):                   # 按分数降序取框,抑制与已保留框 IoU 超阈者
    order, keep = sorted(range(len(scores)), key=lambda i: -scores[i]), []
    while order:
        i = order.pop(0)
        keep.append(i)
        order = [j for j in order if iou(boxes[i], boxes[j]) <= thr]   # 阈值决定近邻框去留
    return keep
NMS 阈值决定的是「多大的重叠算同一个物体」:阈值低于近邻框的 IoU 时,密集场景里本该保留的邻框被一并抑制,召回在这里丢失;阈值过高则重复框留在结果里,按「每个真值只匹配一次」的评测口径计为误检。判据因此固定:NMS 阈值按物体密度定,评测口径要与训练脚本一致,否则同一个模型会算出不同的 AP。
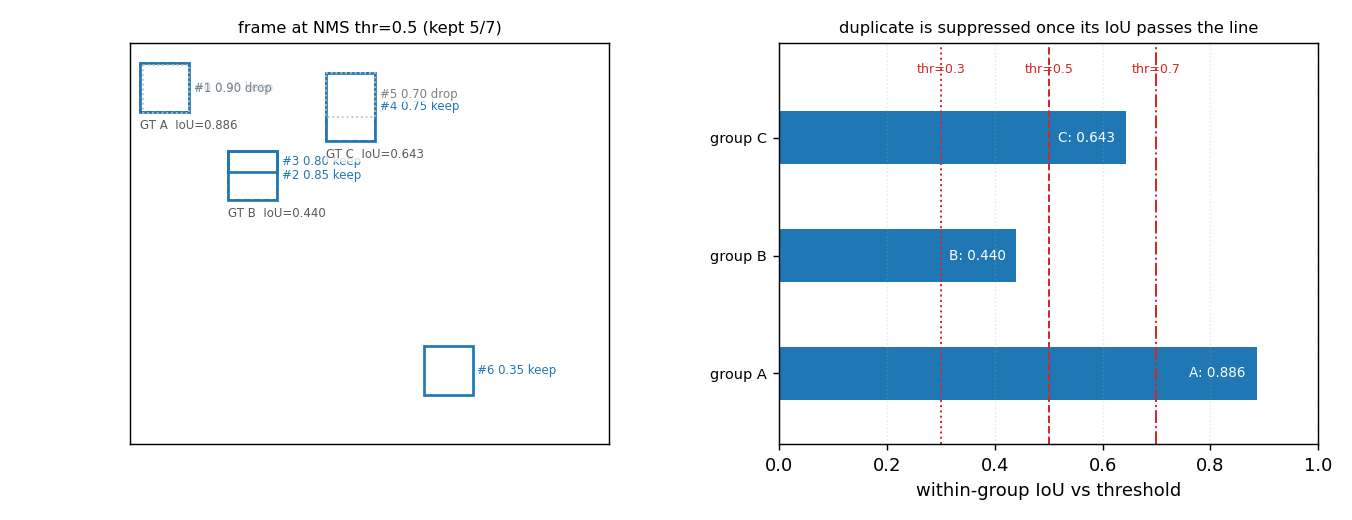
左图是阈值 0.5 时的场景:虚线为真值框,实线保留、点线抑制,组 A 的重复框越过阈值即被丢弃;右图把三组组内 IoU 画成横条、三个阈值画成竖线,横条越过哪条竖线,对应重复框就在该阈值下被抑制。阈值 0.3 的竖线落在组 B 左侧,这就是"密集场景召回被牺牲"的几何来源。
4. 视觉标志与位姿解算
AprilTag(FIDUCIAL 标记,承接 ROS2-note 第 8 章的 ROS 侧检测)把已知尺寸的方形编码贴在目标上,检测角点后用第 1 章的 solvePnP 直接解出 6 自由度相对位姿——这是"用几何 + 已知物"绕过语义不确定性的经典:不需要网络、标定一次即米制可靠。二维码内容解码走定位+数据两用途,位姿解算则靠四角共面 PnP。
## AprilTag 四角像素 + 标记物理半边长 → PnP → 相对位姿(算法承接第 1、2 章)
rvec, tvec = cv2.solvePnP(obj3d, corners2d, K, None, flags=cv2.SOLVEPNP_IPPE_SQUARE)  # 方形共面标记
标记距离越远、像素占比越小,位姿精度随第 2 章的 \(1/\text{基线}\) 规律退化;这是标志法在远距离失效的几何根因。
两个几何细节决定精度上限:方形共面标记的 PnP 有双解歧义(IPPE 专为此设计,但大倾角下仍可能给出镜像解,通常按重投影误差与可见性挑一解);边长误差同比进入深度——标记实际尺寸比设定值大 1%,测出的距离就小 1%。板上贴多个标记或做成阵列,能把姿态估计从单标记的弱约束变成多约束平均。
5. 视觉位置识别与基础模型
- 视觉位置识别(visual place recognition, VPR):把整帧图像编码成一个全局描述子,检索"这个位置以前见过吗",用于重定位回环(NetVLAD、AnyLoc 类为一句名目,第 3 章重定位分工的语义版)。
- 基础模型(
segment-anything的 SAM、CLIP 类)在机器人语境下的最小用法:SAM 给"提示 → 掩膜"的零切分(点/框/掩膜任一提示),CLIP 给"图像-文本"开放词汇匹配。二者组合可实现零样本"找到所有红色的可抓物体"。但 SAM 并非零样本万能分割——提示工程敏感、领域分布外退化(第 10 章失效判据)。
具体权重下载、加载 API 与提示词接口在 torch 生态形态变化快,ultralytics/mmdet/detectron2/SAM/CLIP 的可用版本与许可一律标「待核实」。
SAM 的 API 形态:segment-anything 包的核心是两个类——SamPredictor(提示式:先 set_image 编码一次,之后以点、框或掩膜提示出选掩膜)与 SamAutomaticMaskGenerator(网格撒点、不需提示,一次出全部掩膜,适合离线建库而不是每帧跑):
from segment_anything import SamPredictor, sam_model_registry

sam = sam_model_registry["vit_b"](checkpoint="sam_vit_b_01ec64.pth").to("cuda")
predictor = SamPredictor(sam)
predictor.set_image(rgb)                       # 一次图像编码,后续提示复用
masks, scores, _ = predictor.predict(box=bbox_xyxy, multimask_output=True)
best = masks[scores.argmax()]                  # (H, W) 布尔掩膜
两个行为:一次提示返回三份不同尺度的候选掩膜,按返回的 IoU 预估分数挑;框提示比点提示稳,点提示需要正/负标签区分前景与背景。
变体谱系:SAM 2 在图像编码器之外加了记忆注意力,同一段视频里用掩膜提示逐帧传播,机器人连续帧场景不必每帧重新给框;MobileSAM 把图像编码器换成轻量 ViT,是边缘与实时场景的取舍项;HQ-SAM 在细边界质量上加分。权重与许可按各仓库说明,压测前先固定版本。
接入机器人链路的三个缺口:①无语义——SAM 是类别无关的,框/点只告诉它“分出来”,不告诉它“是什么”,类别要靠检测器(开放词汇检测给框)或 CLIP 标签补;②无三维——掩膜是 2D 像素,要用深度图反投影才有点云(第 1、5 章的相机模型与反投影),再交给配准与抓取(manipulation 笔记第 6 章);③实时性——ViT-H 的图像编码耗时不适合高频闭环,MobileSAM 或更小 backbone 才进实时回路。
VPR 的评估看召回@N 而不是分类准确率:正确地点落在检索前 N 名里就算成功,因为下游还有几何校验兜底。单帧检索对光照与季节敏感,序列匹配(用连续几帧的一致性投票)比逐帧检索稳得多。CLIP 侧的相似度同样只在同一候选集内可比:换一批候选文本或换一张查询图,绝对分数就失去意义,阈值必须按候选集重标定。
6. 要点
- 三层手段(几何 / 判别式 / 基础模型)按"要不要语义、要不要零样本、要不要实时与绝对精度"选型;接一个检测器只是起点,选型与后处理才是工作量。
- 骨干(ResNet/ViT/ConvNeXt)只作特征来源,训练数学不在覆盖范围。
- 任务三档:分类给标签、检测给框、分割给逐像素;分割再分语义/实例/全景。
- 视觉标志用已知尺寸 + PnP 米制定位,绕开语义不确定性,远距按 \(1/\text{基线}\) 退化。
- VPR 管"见过没"、基础模型管开放词汇;SAM 是类别无关的提示式分割(语义靠检测器或 CLIP 补,二维掩膜要配深度才能落成三维),变体按视频(SAM 2)与边缘(MobileSAM)选,权重与 API 形态标待核实。
参考文献与延伸阅读
- He, K., Zhang, X., Ren, S., & Sun, J. Deep Residual Learning for Image Recognition. CVPR, 2016. DOI
- Dosovitskiy, A., Beyer, L., Kolesnikov, A., et al. An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale. ICLR, 2021. arXiv
- Redmon, J., Divvala, S., Girshick, R., & Farhadi, A. You Only Look Once: Unified, Real-Time Object Detection. CVPR, 2016. DOI
- Kirillov, A., Mintun, E., Ravi, N., et al. Segment Anything. ICCV, 2023. arXiv