第 9 章 视觉-语言-动作概览
视觉-语言-动作(vision-language-action,VLA)模型把感知、语言理解与动作生成端到端接成一体,是当前具身智能的一条前沿主线。只做概览:讲清 VLA 的输入输出形态、它在感知流水线里占哪个接口位、以及与传统分层感知相比的取舍;不训练也不部署 VLA,所有具体模型的可用形态一律标「待核实」。这里的定位是为 isaac-note 的 GR00T 留白补感知侧接口位。
三层接口的输入输出位置:
flowchart LR
    obs["视觉观测"] --> vlm["VLM:开放词汇感知"]
    obs --> vla["VLA:动作生成"]
    lang["语言指令"] --> vla
    vlm --> vla
    vla --> act["动作块 → 控制接口"]
1. 三层接口的定位
把机器人软件栈按"感知 → 理解 → 决策 → 控制"分层,前八章的感知都在最底层产出结构化观测量(点云、框、占据、位姿)。VLA 试图跨越中间几层:
传统分层:像素 → [感知网络] → 物体/位姿 → [任务规划] → 动作 → [控制器]
VLA 端到端:(图像 + 语言指令) → [VLA] → 动作 / 动作 token
分层的价值是每层可解释、可单独验证、可用几何先验保精度;端到端 VLA 的价值是省去人工设计的中间表示、能借大模型的开放语义与常识。二者不是替代而是互补:VLA 落地仍需底层感知提供可靠的几何/度量接口(抓取点的米制坐标、可通行区)。
接口位的实质是三个具体问题:动作空间用什么表示(关节角、末端位姿增量还是速度)、时间基准怎么对齐(推理时延导致的指令滞后由谁补偿)、单位与坐标系是米/弧度、基座系还是工具系。三项与控制器不一致,端到端输出再准也执行不了;反过来,只要接口钉死,VLA 与分层方案就能在同一套控制接口上互换,而不必重写下游。
2. VLM 做开放词汇感知
视觉-语言模型(vision-language model,VLM)本身不产动作,但可作为感知层的"语义引擎":输入图像 + 文本查询,输出开放词汇的检测/分割/关系。GR00T 一类具身基础模型(覆盖范围归 isaac-note)把 VLM 的语义骨干接进行为克隆。感知侧看,VLM 补的是"传统检测器只认训练类别"的短板——但它给的是概率性、可能幻觉的输出(第 7 章 SAM/CLIP 边界的延伸),用于安全关键路径必须降级兜底(第 10 章)。
语义落到度量还有一步常被跳过:开放词汇检测给的是图像平面上的框或掩码,要变成机械臂能用的三维点,必须有相机内参与深度或位姿(第 1、4 章);而"物体中心"折算到抓取坐标系时还要考虑可见面偏置——单目看到的是可见面,不是质心。语义对、几何偏,是这类系统最常见的失败形态。
3. VLA 的输入输出形态
一句名目谱系(RT-2 / OpenVLA / Octo / GR00T 等,具体公开可用形态与许可标「待核实」):
- 输入:多路相机图像序列 + 自然语言任务指令(有的拼本体状态)。
- 输出:直接回归连续动作,或把动作离散成 token 交还控制器;控制频率通常需与底层伺服解耦(VLA 低频出高层动作、控制器高频跟随)。
- 训练范式:在大规模机器人演示上行为克隆,靠视觉-语言预训练骨干迁移开放语义——训练流程不在感知这一层。
选型判据:任务开放、类别多、规则难写时端到端有优势;任务明确、要可验证精度时用第 7–8 章的分层感知 + 经典规划更可控、可审计。
三类动作空间各有代价:直接回归关节角,模型要隐式学运动学与限位;输出末端位姿增量,模型只需学"往哪走",逆解与限位由控制器负责,误差也更可解释;离散 token 把连续量量化,分辨率决定精度上限,动作维度一多 token 序列就长、推理变慢。选哪一类基本由任务精度与控制频率决定,而不是由模型架构决定。
端到端的泛化靠演示数据覆盖:相机型号、光照、背景、物体外观一变,行为克隆的表征就偏移,偏移在几何层表现为尺度与位姿误差、在语义层表现为指令误解。所以部署侧一半工作在数据上——采集时把内参、外参、光照与工作距离一并记录,比事后调模型有效得多。
3.1 分块执行与接缝
VLA 推理频率通常在 1–10 Hz,伺服环在 100–1000 Hz,两者差两三个数量级,"低频出高层动作、高频跟随"是算力事实而非设计偏好。分块(action chunking)把一次推理的结果当作连续 K 帧执行,代价集中在块边界:逐帧推理没有接缝,却把策略噪声原样交给伺服,加速度 RMS 成倍于参考轨迹;分块把块内噪声共模化,整体抖动降下来,但误差集中到接缝——直接执行时接缝速度误差可达名义速度峰值的一半。边界交叉淡入把块尾与块首按权混合,接缝误差随之压到名义速度的百分之几。
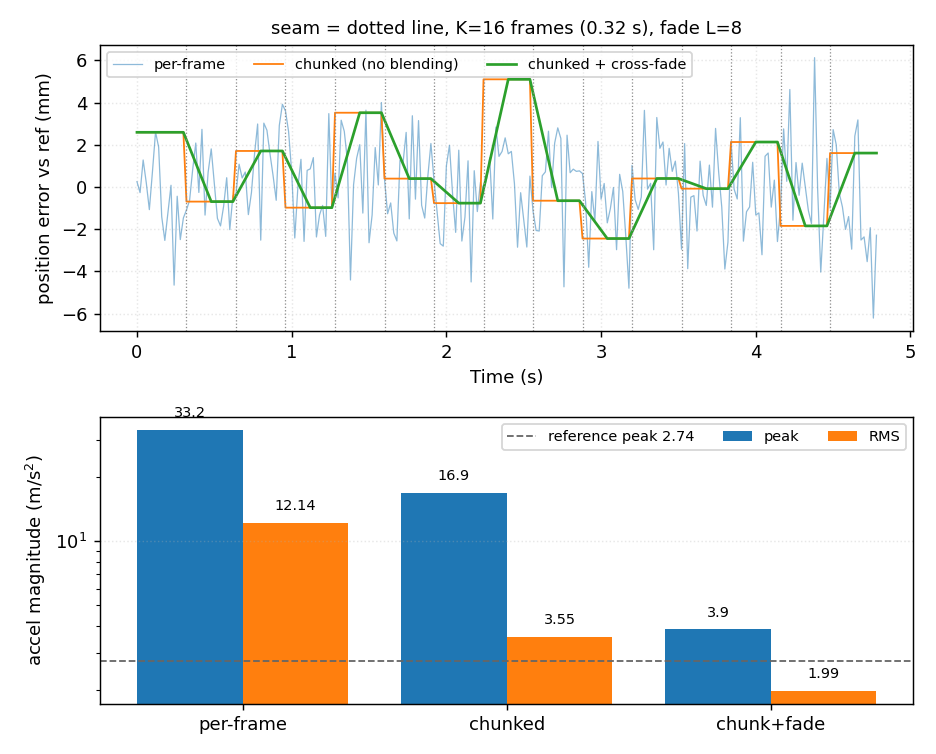
上排是三种执行方式相对参考轨迹的位置误差,点线为块边界:分块直执的误差在块内恒定、到接缝阶跃复位,淡入把这级台阶摊到 L 帧上,逐帧则是逐帧独立的白噪声;下排是加速度峰值与 RMS 的对数对照,参考轨迹的峰值作基准线。
## 接缝交叉淡入:接缝前后 L 帧按线性权把前一块尾段与后一块首段混合
idx = np.arange(k, k + L)
w = (idx - k + 1) / (L + 1)                      # 权重从 0 渐进到 1
c_hat[idx] = (1 - w) * (target[idx] + bias_prev) + w * (target[idx] + bias_next)
判据:块长按任务动程定,接缝必须做混合或滤波;淡入把接缝误差压到名义速度的百分之几,代价是接缝附近约 L 帧的响应滞后,这也是"动作块越长越省算力、越需要平滑层"同时成立的原因。
4. 任务分解与工具链调用
VLA 之外,一条更可控的路线是"大模型做任务分解 + 调用现成感知/技能工具"(LLM planner + API),把"收拾桌子"拆成子任务、逐个调检测/抓取技能。它保留分层可验证性,又借语言的组合泛化,是当前比纯端到端更易落地的折中。工具接口的形态(如何把第 7–8 章的感知输出暴露成可被调用的函数)属执行框架侧,工具 schema 与调用循环归 agent-note 第 4、7 章,此处不展开。
分解路线有自己的失败模式:子任务之间的前置条件不写清,调用顺序就会错(先抓再对准);技能只返回成功/失败、不带结构化原因,规划器就无法根据反馈改计划。这条路线真正的工作量在把技能接口写成"有前置条件、有后置断言、有错误码"的形式,而不在提示词。
另一个隐性成本是状态传递:检测给出的是像素框,抓取技能要的是米制位姿,中间必须有一层把"看到"转成"能抓"的换算,这一层写错,语言层再对也抓空。失败后的重规划同样看接口粒度——技能返回"抓取失败"时,规划器需要知道是没检测到、够不着还是夹爪滑脱,才能选对下一步;只有布尔返回的系统只能整段重试,成功率随子任务数指数衰减。
VLM 并非什么都能理解:模型会幻觉物体与关系、对分布外指令处理不稳,安全关键场景必须有几何/规则校验兜底(第 10 章)。
5. 适用边界
范围止于感知接口判据,不训练也不部署 VLA。VLA 何时该用、用到哪一层,取决于三个可验证性判断:(1) 输出的动作/语义能否被几何或规则层校验;(2) 失败是否有可降级的回退路径;(3) 任务是否真需要端到端才能覆盖的开放组合。任一为否,分层方案通常是更稳的选择。
三条判据之外还有一条工程前提:端到端输出的动作要能被安全层截断(速度、力矩、工作空间限位),否则一次越界输出就是硬件事故。截断与降级属控制与执行侧(control-note);感知侧能做的是把输出限定在控制器可校验的表示上,比如给出带置信度的位姿增量而不是绝对位置。
端到端系统的评估口径与分层系统不同:动作回归损失降下去不等于任务成功率高。行为克隆容易学到"偷看未来帧"的捷径,离线指标漂亮、在线一上手就崩,这类捷径在因果上不可用。可用的口径是任务成功率、人工干预次数与失败类型分布,并且要按对象位姿、光照、背景分组报——平均值会把某一类失败的集中爆发摊平。离线 mAP 同理,它只说明感知本身,进不了"能不能完成任务"这一层。
6. 要点
- VLA 端到端跨层,省中间表示、借大模型开放语义;分层可解释、可用几何先验保精度——互补而非替代。
- VLM 作感知语义引擎补开放词汇短板,但输出概率性、会幻觉,安全关键路径需兜底。
- VLA 输入图像+语言、输出连续动作或动作 token,控制频率需与底层伺服解耦;不复现训练。
- 更可控的折中是 LLM 任务分解 + 调用现成感知/抓取技能,保留分层可验证性。
- 只给感知接口判据、不训不部署 VLA;用不用端到端看三条可验证性判断。
参考文献与延伸阅读
- Brohan, A., Brown, N., Carbajal, J., et al. RT-1: Robotics Transformer for Real-World Control at Scale. RSS, 2023. arXiv
- Brohan, A., Brown, N., Carbajal, J., et al. RT-2: Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. CoRL, 2023. arXiv
- Kim, M. J., Pertsch, K., Karamcheti, S., et al. OpenVLA: An Open-Source Vision-Language-Action Model. CoRL, 2024. arXiv
- Octo Model Team. Octo: An Open-Source Generalist Robot Policy. RSS, 2024. arXiv